nsh中的工具
ps命令的使用与内部机制
ps命令的作用是“report a snapshot of the current processes”:报告当前时刻各个进程的快照,即显示当前时刻各个进程的状态。
配置和使用
要想使用ps命令的更多功能,可以如下配置:
# 不配置 CONFIG_SCHED_CPULOAD_NONE,
# 不配置 CONFIG_NSH_DISABLE_PSSTACKUSAGE
# 不配置 CONFIG_FS_PROCFS_EXCLUDE_CPULOAD
# 不配置 CONFIG_NSH_DISABLE_PSHEAPUSAGE
CONFIG_FS_PROCFS=y
CONFIG_SCHED_CPULOAD_SYSCLK=y
CONFIG_MM_BACKTRACE=8
CONFIG_STACK_COLORATION=y
ps命令的用法为:
ps [-heap] [pid1 pid2 ...]
可以执行这样的命令:
ps # 查看所有线程状态
ps -heap # 查看所有线程状态,包括它们使用堆的信息
ps 12 # 查看PID=12的进程的状态
ps -heap 12 # 查看PID=12的进程的状态,包括它堆的信息
示例:
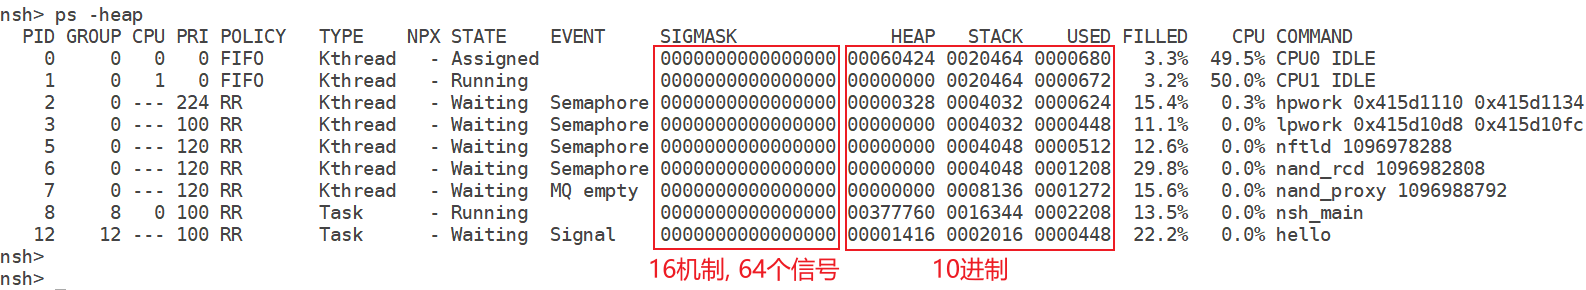
| 字段 | 含义说明 | 示例值(对应PID=12的进程) |
| PID | 进程/任务ID,系统中唯一标识一个任务的编号。 | 12 → 该任务的ID是12。 |
| GROUP | 进程组ID,用于进程组管理(通常与PID相同,除非有特殊分组)。 | 12 → 进程组ID为12。 |
| CPU | 任务当前运行的CPU核心(多核系统中有效,单核系统中通常为0)。 | 单核系统,无特定CPU核心标识。 |
| PRI | 任务优先级,数值越大优先级越高(NuttX中通常范围0-255)。 | 100 → 优先级为100,属于中等偏上优先级。 |
| POLICY | 调度策略:- RR:时间片轮转调度(Round-Robin)- FIFO:先进先出调度 | RR → 采用时间片轮转调度,多个同优先级任务轮流执行。 |
| TYPE | 任务类型:- Task:普通任务 - KThread:内核线程 | Task → 该进程是用户态普通任务。 |
| NPX | 未使用的协处理器数量(通常为 -)。 | - → 无协处理器使用。 |
| STATE | 任务当前状态:- Waiting:等待状态(等待事件/信号)- Running:运行中 | Waiting → 任务正处于等待状态。 |
| EVENT | 任务等待的事件类型:- Signal:等待信号 - Sem:等待信号量等 | Signal → 任务正在等待一个信号(如sigwait等待信号触发)。 |
| SIGMASK | 信号屏蔽字(16进制),表示当前被屏蔽的信号(0表示无屏蔽)。 | 0000000000000000 → 无任何信号被屏蔽。 |
| HEAP | 任务堆的总大小(单位:字节),即该任务可使用的堆内存总量。 | 00001416 → 堆总大小为0x1416字节(十进制5142字节)。 |
| STACK | 任务栈的总大小(单位:字节),即分配给该任务的栈内存总量。 | 0002016 → 栈总大小为0x2016字节(十进制8214字节)。 |
| USED | 堆的已使用大小(单位:字节),即当前已分配的堆内存。 | 0000448 → 已使用堆内存448字节。 |
| FILLED | 栈的填充率(百分比),反映栈的使用紧张程度(接近100%可能栈溢出)。 | 22.2% → 栈已使用22.2%,剩余空间充足。 |
| CPU | 任务累计使用的CPU时间百分比,反映任务的CPU占用率。 | 0.0% → 几乎未使用CPU时间。 |
| COMMAND | 任务对应的命令/程序名。 | hello → 该任务是hello程序启动的。 |
以上图最后一行“hello”程序的信息为例进行解析:
内部机制
ps命令是内嵌命令,对应函数为“cmd_ps”,源码在“apps/nshlib/nsh_proccmds.c”。它从“/proc”目录下获得各个进程/线程的信息,以PID=12的进程为例,可以在“/proc/12”目录下看到如下信息,可以看到ps命令只是读取这些文件并且整理输出:
nsh> ps -heap 12
PID GROUP CPU PRI POLICY TYPE NPX STATE EVENT SIGMASK HEAP STACK USED FILLED CPU COMMAND
12 --- 100 RR Task - Waiting Signal 0000000000000000 00001416 0002016 0000448 22.2% 0.0% hello
nsh>
nsh>
nsh> ls /proc/12
/proc/12:
status
cmdline
loadavg
heap
stack
group/
nsh> cat /proc/12/status
Name: hello
Type: Task
Group: 12
CPU: ---
State: Waiting,Signal
Flags: -
Priority: 100
Scheduler: SCHED_RR
SigMask: 0000000000000000
nsh> cat cmdline
hello
nsh> cat heap
AllocSize: 1416
AllocBlks: 19
nsh> cat stack
StackAlloc: 0x416dde78
StackBase: 0x416dde98
StackSize: 2016
StackUsed: 448
nsh>
nsh>
nsh> cd /proc/12
nsh> ls
/proc/12:
status
cmdline
loadavg
heap
stack
group/
nsh>
nsh> cat status
Name: hello
Type: Task
Group: 12
CPU: ---
State: Waiting,Signal
Flags: -
Priority: 100
Scheduler: SCHED_RR
SigMask: 0000000000000000
nsh>
nsh> cat cmdline
hello
nsh>
nsh> cat loadavg
.0%
nsh>
nsh> cat heap
AllocSize: 1416
AllocBlks: 19
nsh>
nsh> cat stack
StackAlloc: 0x416dde78
StackBase: 0x416dde98
StackSize: 2016
StackUsed: 448
nsh>
nsh> ls group
/proc/12/group:
status
fd
env
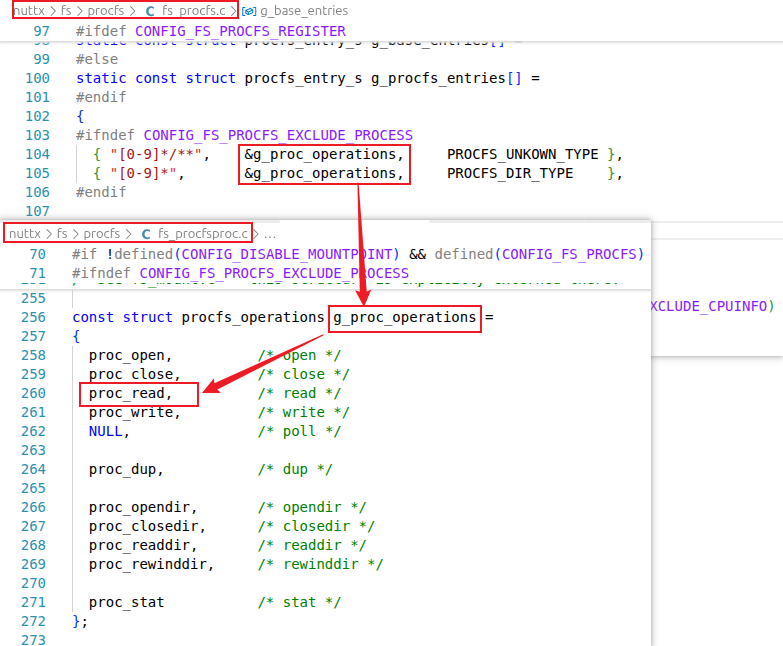
ps命令读取“/proc/<PID>”目录下的文件时,导致这个函数被调用:
top命令的使用与内部机制
top 命令用于实时监控系统中任务(进程)的资源占用情况(如 CPU 使用率、内存使用等),类似 Linux 中的 top 命令。
配置和使用
要想使用top命令,可以如下配置:
# 不配置 CONFIG_NSH_DISABLE_TOP
# 不配置 CONFIG_FS_PROCFS_EXCLUDE_CPULOAD
# 不配置 CONFIG_SCHED_CPULOAD_NONE
# 不配置 CONFIG_NSH_DISABLE_PS
CONFIG_FS_PROCFS=y
CONFIG_SCHED_CPULOAD_SYSCLK=y
top命令的用法为:
top [ -n <num> ][ -d <delay>] [ -p <pidlist>] [-h]
-
“-n <num>”:显示进程数量(CPU占用率最高的num个进程/线程)
-
“-d <delay>”:指定刷新间隔(单位:秒,支持小数),不指定时默认间隔为3秒
-
“-p <pidlist>”:指定监控的任务,格式为“top -p 12,13”,PID间用逗号隔开
-
“-h”:显示帮助信息
-
按“ctrl+c”退出
示例:
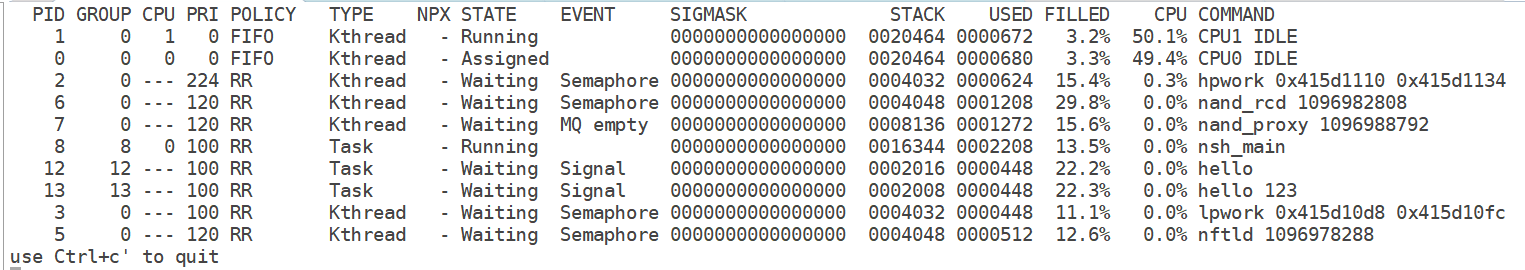
显示的内容跟ps命令是一样的,只不过会根据“CPU”占用率进行动态排序。
内部机制
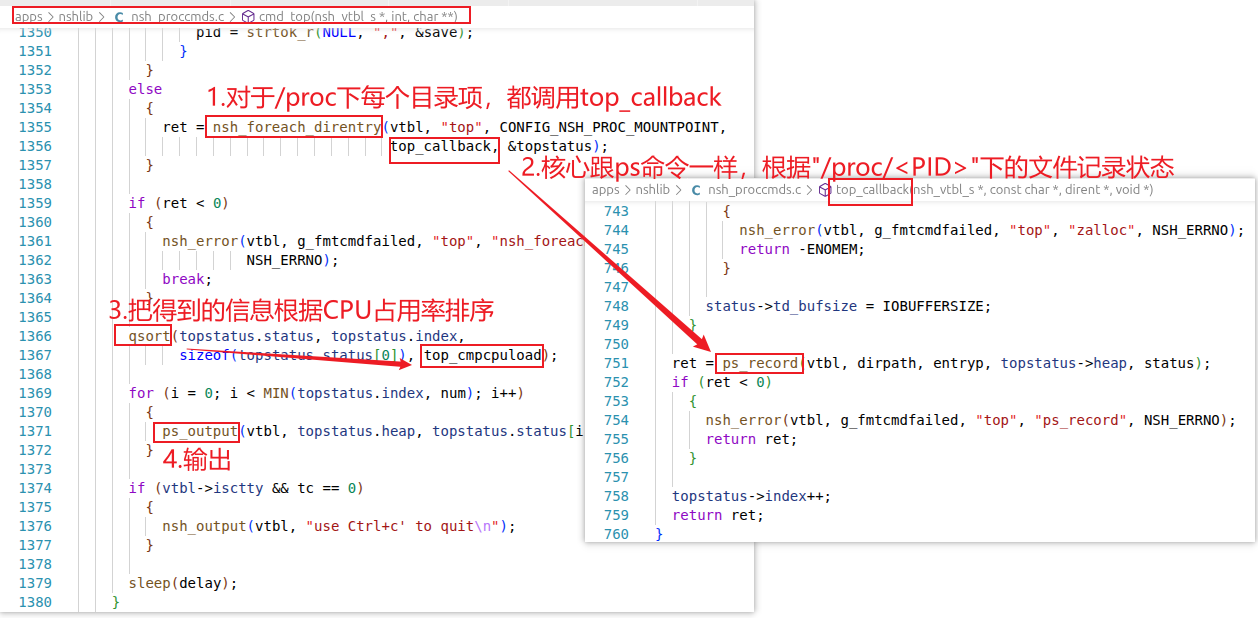
top命令对应的“apps/nshlib/nsh_proccmds.c”的“cmd_top”函数,流程如下:
openvela堆的内部机制
核心结构体
openvela里,“堆”一开始是一个巨大的“空闲内存块”,应用程序可以使用malloc函数、驱动程序可以使用kmm_malloc函数从里面分配出“指定大小的内存”,使用完毕后再通过free函数、kmm_free函数把它“还回去”。需要说明的是,“kmm_malloc/kmm_free”就是“malloc/free”。
经过多次malloc、free后,堆里会有“多个零散的、未使用的空闲块”、“多个在使用的空闲块”。
openvela的堆算法里,怎么管理这些“未使用的内存块”、“在使用的内存块”?
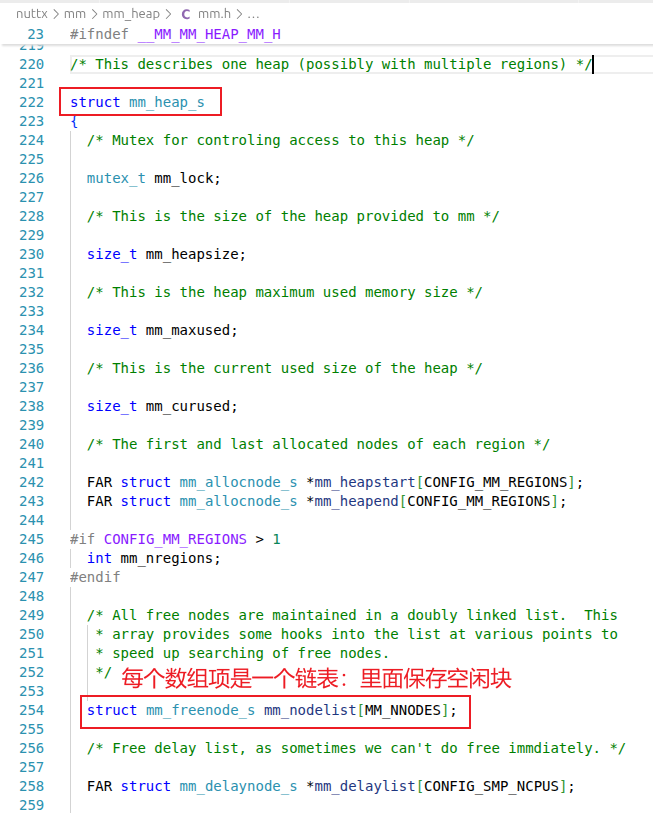
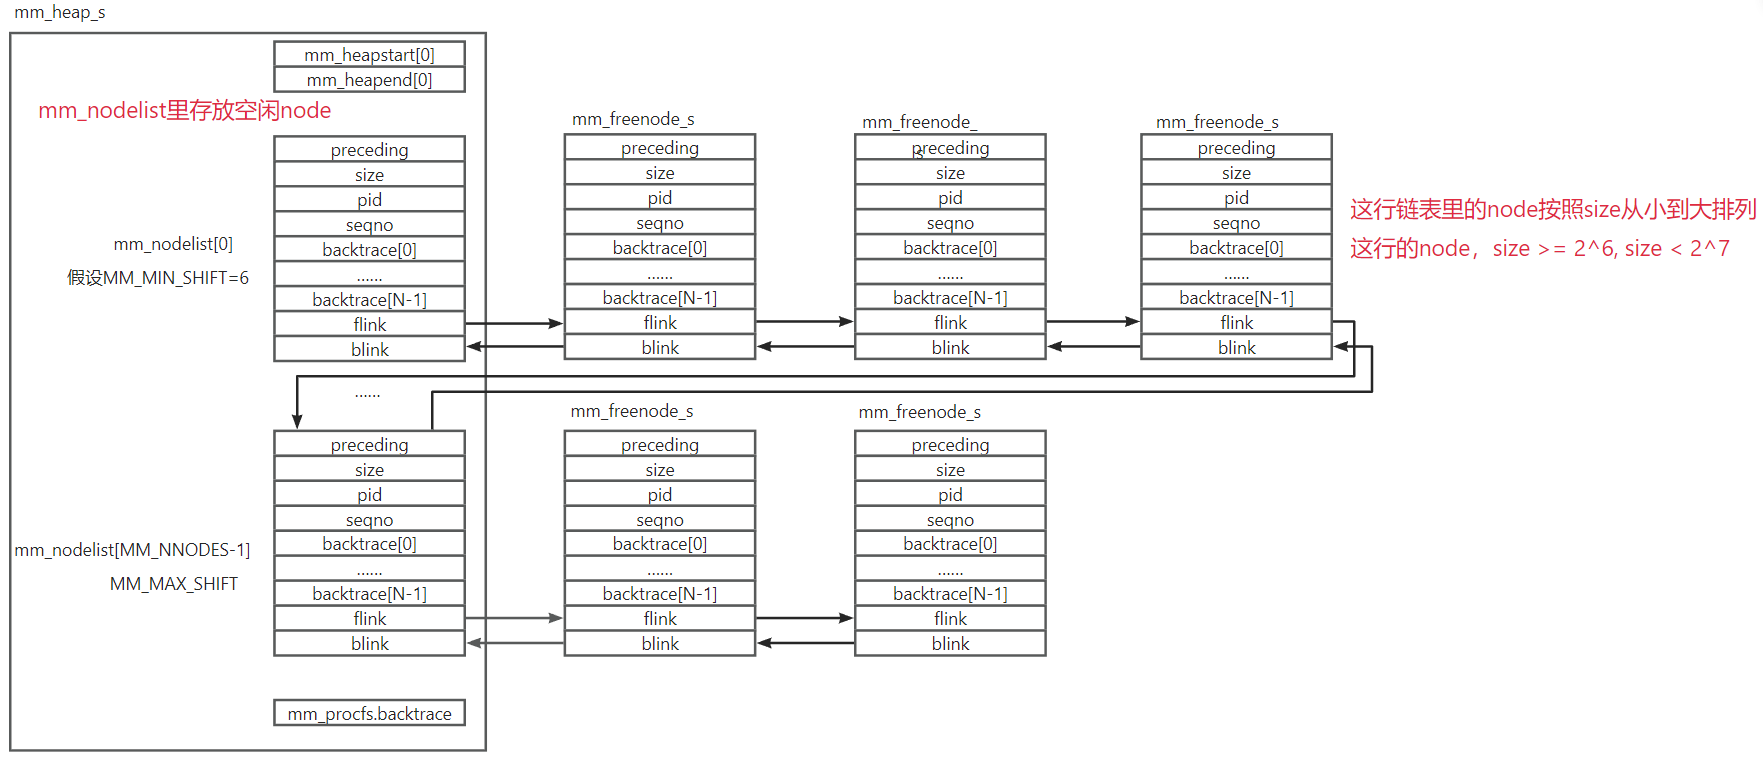
使用“struct mm_heap_s”结构体来表示“堆”,里面的“struct mm_freenode_s mm_nodelist[MM_NNODES]”是多个链表,每个链表里存放“空闲chunk”(空闲内存块):
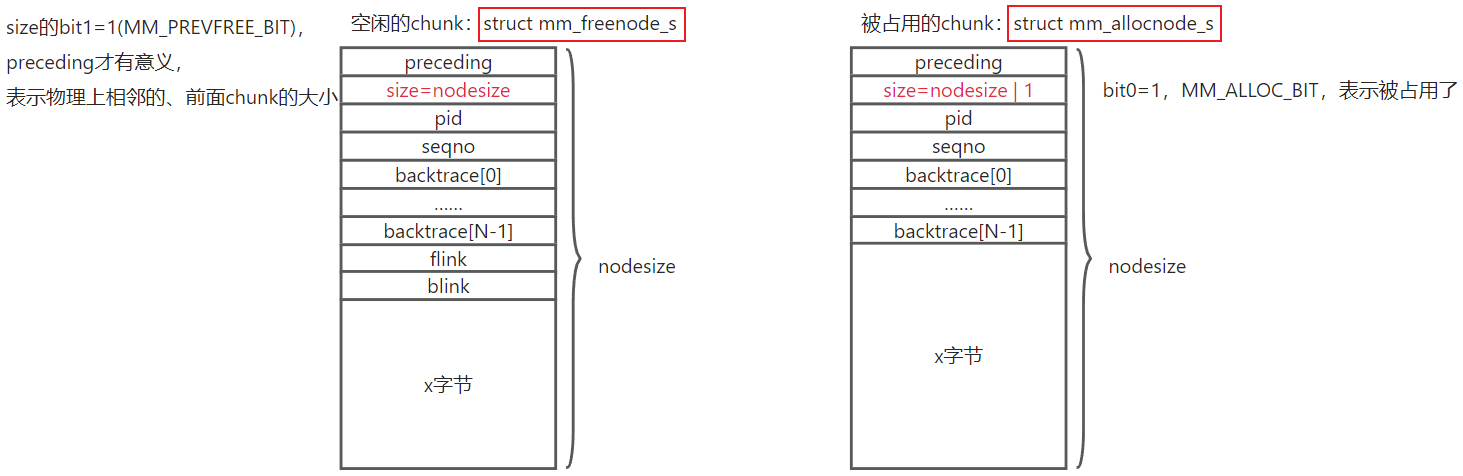
空闲内存块、正在使用的内存块,都被称为“chunk”,chunk由头部的node结构体、紧随其后的内存组成,它们的结构如下:
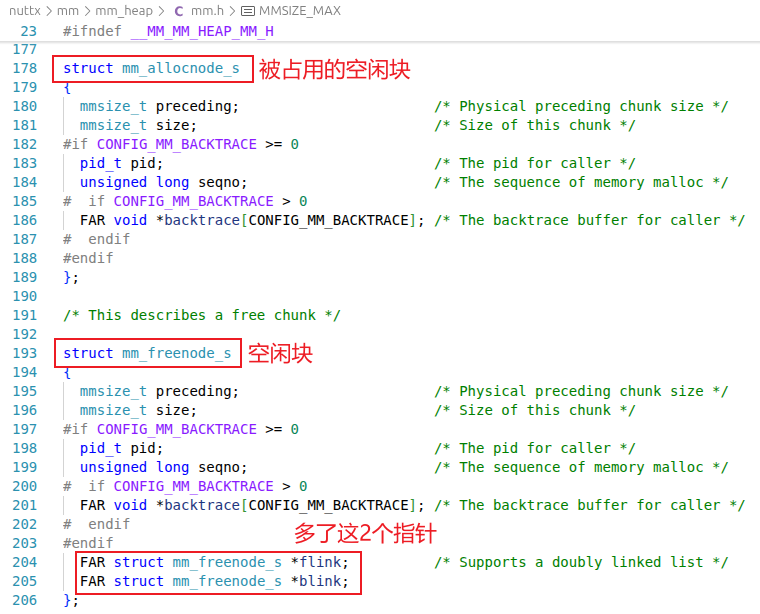
空闲chunk、被分配出去(被占用)的chunk,它们的头部分别使用这2个结构体来表示:struct mm_freenode_s、struct mm_allocnode_s。代码如下:
堆的算法
openvela的堆算法,核心在于:
-
使用不同的链表来管理“各个size级别的、空闲的chunk”
比如“struct mm_heap_s”结构体里,使用mm_nodelist[0]链表记录“size >= 2^6, size < 2^7”的chunk;使用mm_nodelist[1]链表记录“size >= 2^7, size < 2^8”的chunk。
并且,这些链表里各个chunk按照从小到大排序 -
执行malloc(size)时,根据size找到mm_nodelist[x]链表,遍历里面的node,找到最合适的chunk,后面将返回它的数据块的地址;如果mm_nodelist[x]链表为空,还会进入下一级的mm_nodelist[x+1]链表来继续查找
-
如果这个chunk太大,还要把它拆分:拆分出来的chunk再加入某个mm_nodelist[y]链表
-
执行free(ptr)时,根据ptr往前确定node结构体,把这个node放回某个mm_nodelist[z]链表
-
如果这个chunk前面、后面有相邻的chunk,还要合并起来得到新的chunk:因为大小发生了变化,还要重新放入某个mm_nodelist[w]链表
堆的初始化过程情景分析
看视频。
函数调用关系:
nx_start
up_allocate_heap(&heap_start, &heap_size);

kumm_initialize(heap_start, heap_size);
umm_initialize(h,s)
// nuttx/include/nuttx/mm/mm.h

// \# define USR_HEAP g_mmheap

USR_HEAP = mm_initialize_pool("Umem", heap_start, heap_size, NULL);

// \# define mm_initialize_pool(name, heap_start, heap_size, init) \\

// mm_initialize(name, heap_start, heap_size)

// nuttx/mm/mm_heap/mm_initialize.c
mm_initialize
结果如下:
-
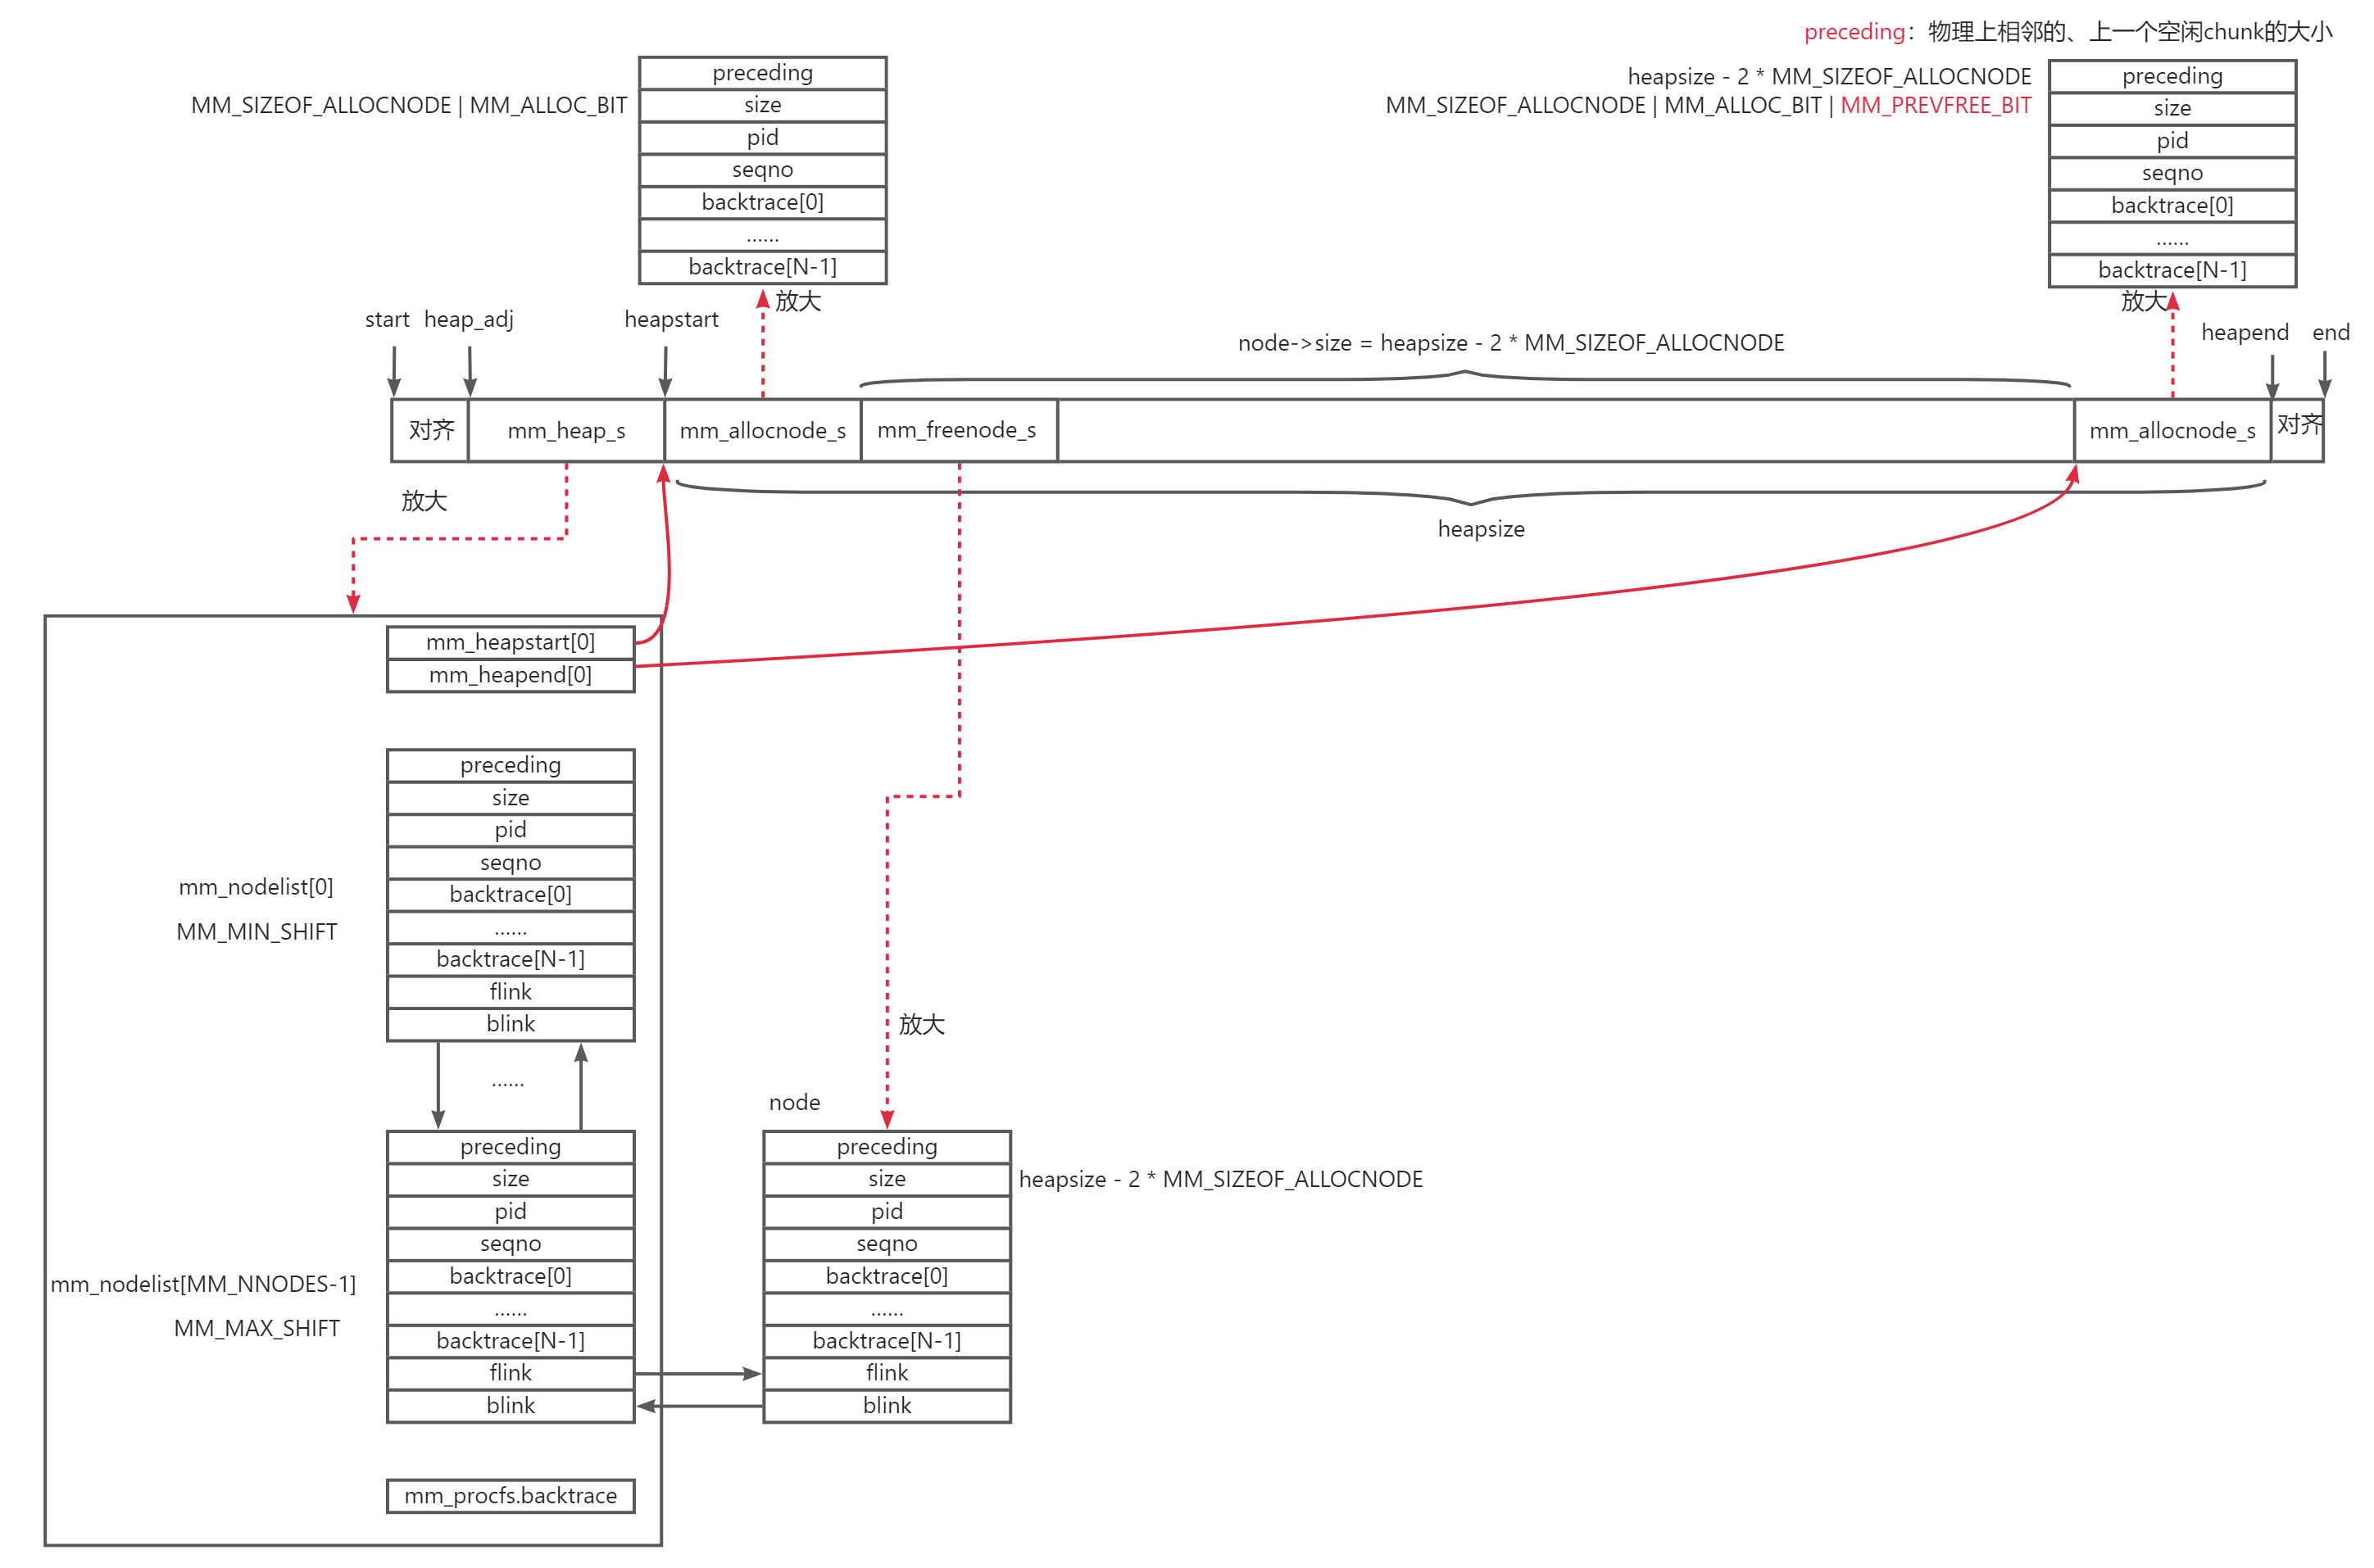
在堆的前面分配了一个“mm_heap_s”结构体,g_mmheap指向它
-
剩下的内存被分为3个node:开始node(mm_heapstart[0])、结尾node(mm_heapend[0])、一开始最大的空闲node
mm_heapstart[0]指向第1个内存块的起始位置,意味着mm_heapstart[1]指向第2个内存块,即:openvela可以支持物理上分隔开的多个堆 -
空闲node被放入链表
malloc过程情景分析
看视频。
函数调用关系:
# APP调用malloc
# 内核/驱动调用 kmm_malloc 也是调用 malloc
// nuttx/mm/umm_heap/umm_malloc.c
malloc
ret = mm_malloc(USR_HEAP, size);

// 难点

alignsize = MM_ALIGN_UP(size + MM_ALLOCNODE_OVERHEAD);

ndx = mm_size2ndx(alignsize);

// 遍历heap-\>mm_nodelist\[ndx\]

// 找到第1个适合的freenode

// 1. 如果大小差不多

// 把这个freenode从链表中移除

// 2. 如果太大了(拆分出来的空间还大于node头部)

// 拆分出新node

// 把新node放入链表

// 返回node之后的内存

ret = (FAR void \*)((FAR char \*)node + MM_SIZEOF_ALLOCNODE);

// 记录调试信息,比如pid, 序列号seq, backtrace

MM_ADD_BACKTRACE(heap, node);
结果如下:
-
malloc(size)时,根据size计算链表ndx
-
遍历g_mmheap->mmnodelist[ndx],找到合适的freenode
-
如果这个freenode太大,还要把它拆分:拆分出来的freenode再加入某个mm_nodelist[y]链表
-
返回“freenode+头部”,就是返回头部后面的buffer给调用者
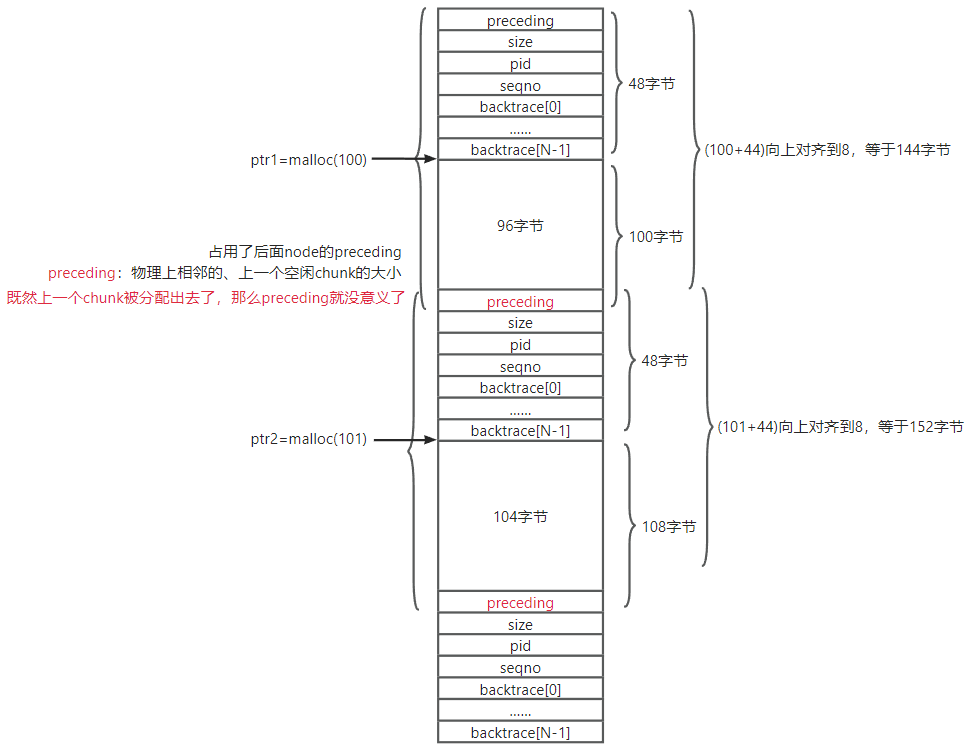
malloc函数里比较难以理解的是:它会占用下一个node的“preceding”。下一个node的preceding表示物理上相邻的、上一个空闲的chunk的大小。但是当前node已经被占用了,“下一个node的preceding”就没有意义了,那就把它用起来。
free过程情景分析
看视频。
函数调用关系:
# APP调用free
# 内核/驱动调用 kmm_free 也是调用 free
// nuttx/mm/umm_heap/umm_free.c
free
mm_free(USR_HEAP, mem);

mm_delayfree(heap, mem, CONFIG_MM_FREE_DELAYCOUNT_MAX \> 0);

// 如果配置了CONFIG_MM_FREE_DELAYCOUNT_MAX

// 就加入delaylist后面再真正释放

// 以后delaylist里累加的node数 \>= CONFIG_MM_FREE_DELAYCOUNT_MAX

// 就调用free_delaylist执行真正的释放操作

add_delaylist(heap, mem);

// 如果CONFIG_MM_FREE_DELAYCOUNT_MAX=0

// 立刻释放

// 1. 根据地址往前推得到node
node = (FAR struct mm_freenode_s *)
((FAR char \*)kasan_reset_tag(mem) - MM_SIZEOF_ALLOCNODE);

nodesize = MM_SIZEOF_NODE(node);

// 2. 先判断next node是否freenode,

// 若是: 把next从链表里移除, 然后合并它们

// 3. 再判断pre node是否freenode

// 若是: 把pre从链表里移除, 然后合并它们

// 4. 放入链表

mm_addfreechunk(heap, node);
memdump和free命令的使用与内部机制
memdump
要想使用memdump命令,可以如下配置:
# 不配置 CONFIG_NSH_DISABLE_MEMDUMP
CONFIG_DEBUG_FEATURES=y
CONFIG_DEBUG_MM=y
使用memdump命令来查看堆的使用情况,用法如下:
nsh> cat /proc/memdump
usage: <used/free/orphan/biggest/on/off/leak/pid> <seqmin> <seqmax>
used: dump all allocated node
free: dump all free node
orphan: dump allocated free neighbored node
biggest: dump allocated top n node
on/off: set backtrace enabled state
leak: dump all leaked node
pid: dump pid allocated node
更详细的用法看下表:
<table> <colgroup> <col style="width: 33%" /> <col style="width: 38%" /> <col style="width: 28%" /> </colgroup> <tbody> <tr class="odd"> <td>memdump命令</td> <td>/proc/memdump文件</td> <td>说明</td> </tr> <tr class="even"> <td>memdump或memdump used</td>
<td>echo used > /proc/memdump</td>
<td>显示已经分配的内存块</td> </tr> <tr class="odd"> <td>memdump free</td>
<td>echo free > /proc/memdump</td>
<td>显示空闲的内存块</td> </tr> <tr class="even"> <td>memdump orphan</td>
<td>echo orphan > /proc/memdump</td>
<td>显示“孤儿”内存块:它是空闲的,但是没有跟相邻的空闲内存块合并起来</td> </tr> <tr class="odd"> <td>memdump biggest</td>
<td>echo biggest > /proc/memdump</td>
<td>列出已经分配的最大的内存块</td> </tr> <tr class="even"> <td>memdump leak</td>
<td>echo leak > /proc/memdump</td>
<td>显示泄漏的内存,就是“分配这块内存的进程已经退出,但是没有调用free释放的内存块”</td> </tr> <tr class="odd"> <td><p>memdump on</p> <p>memdump off</p></td>
<td>echo on> /proc/memdump<br />
echo off> /proc/memdump</td>
<td>启动或关闭堆的“backtrace”功能,这是总开关</td> </tr> <tr class="even">
<td><p>memdump <PID> on</p>
<p>memdump <PID> off</p></td>
<td>echo “PID on” > /proc/memdump<br />
echo “PID off” > /proc/memdump</td>
<td>启动或关闭某个进程的堆的“backtrace”功能</td> </tr> <tr class="odd"> <td><p>所有的命令,</p> <p>都可以加上“<seqmin> <seqmax>”</p> <p>比如:</p> <p>memdump used 123 788</p></td>
<td>echo “used 123 788” > /proc/memdump</td>
<td>每次调用malloc,都会记录“这是第几次调用”,这个数字就是seq。每个分配出去的内存块都有seq,可以指定要显示的seq范围。</td> </tr> </tbody> </table>
free
要想使用free命令,可以如下配置:
# 不配置 CONFIG_NSH_DISABLE_FREE
直接执行free命令即可:
nsh> free
total used free maxused maxfree nused nfree name
959896100 961604 958934496 986320 958925080 968 10 Umem
它就是读取“/proc/meminfo”并显示出来。
内部机制
内部机制都是遍历堆里面的所有node,统计信息、打印:
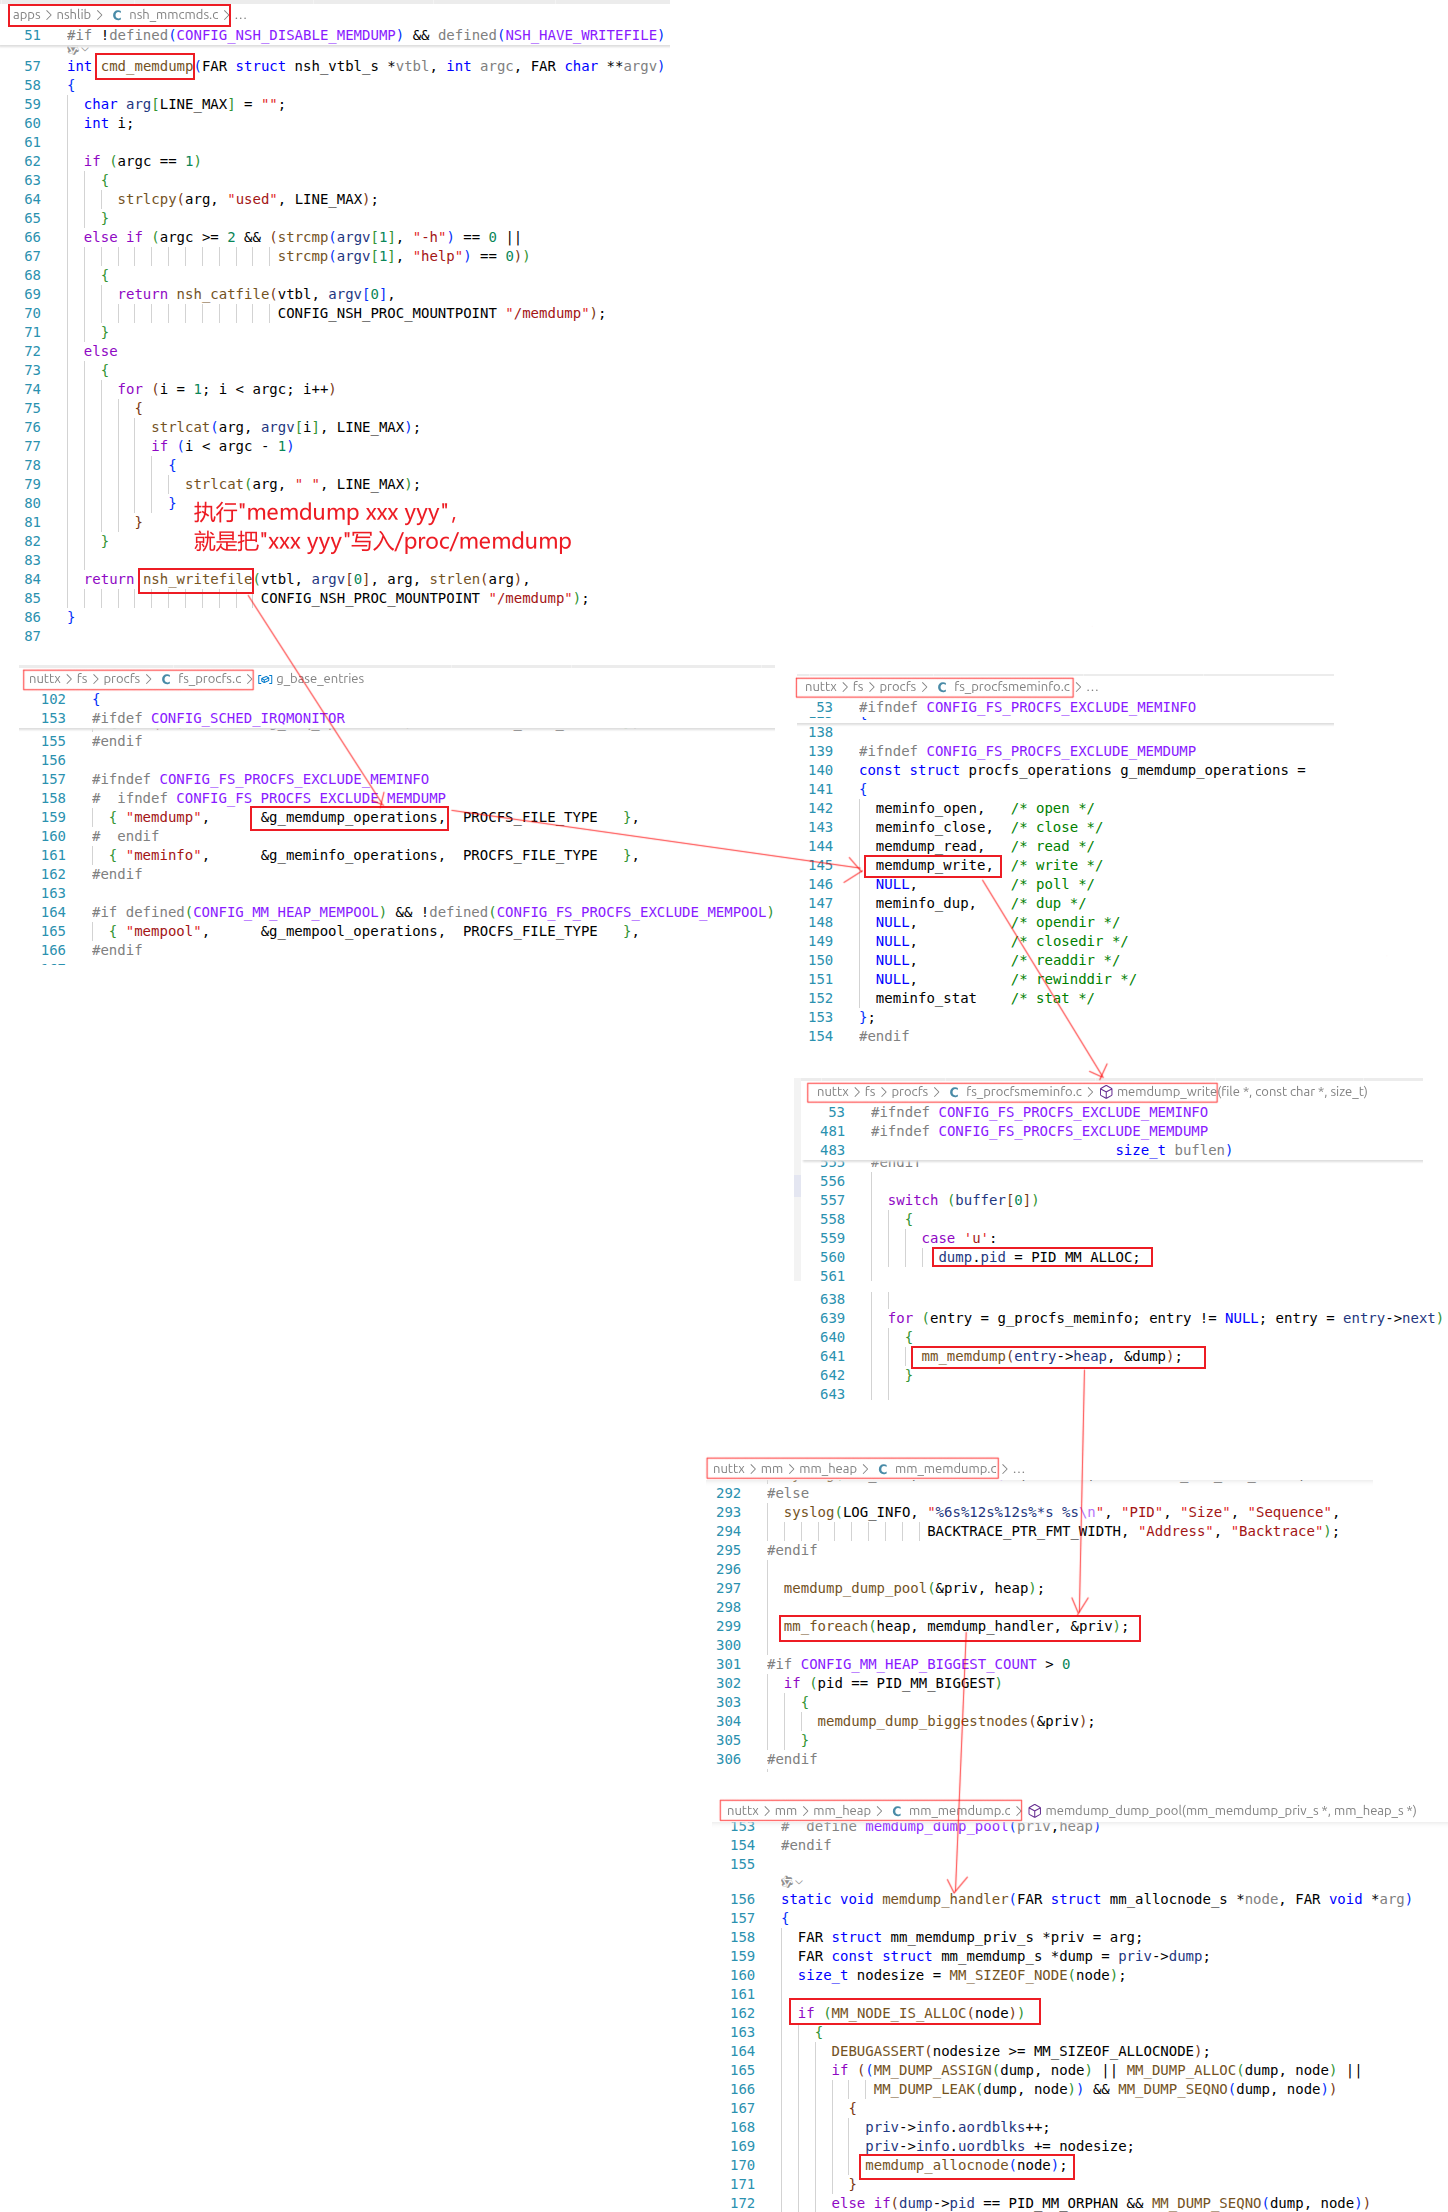
以“memdump used”命令为例,涉及的调用过程如下:
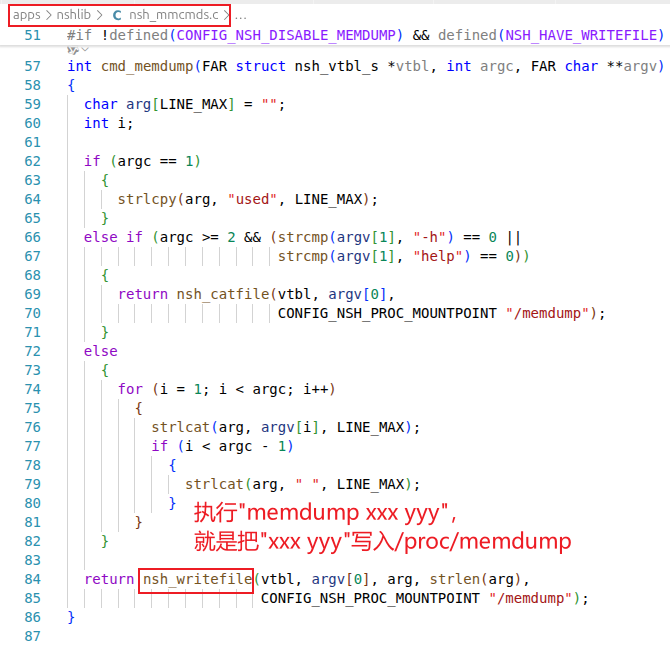
写“/proc/memdump”文件时,涉及如下调用:
“ctrl+?”命令的使用与内部机制
注意:“Ctrl+?”里的问号,可以表示很多字符。Ctrl加上不同的字符代表一些特殊字符。通过串口发送一些特殊字符给开发板,可以触发一些事情。
可见 ASCII 字符的编码范围是 0x20(十进制 32)到 0x7E(十进制 126),共 95 个字符。对于编码值小于0x20的特殊字符,可以使用Ctrl和字母产生,规则是:可见字符(大写)的ASCII码是m,Ctrl+这个可见字符的编码就是“m-64”。
比如“C”的ASCII码是0x43,那么Ctrl+C的编码就是0x03。
这些特殊编码可以用来进行一些控制,如下表(参考“nuttx/drivers/serial/Kconfig”):
<table> <colgroup> <col style="width: 13%" /> <col style="width: 13%" /> <col style="width: 37%" /> <col style="width: 36%" /> </colgroup> <tbody> <tr class="odd"> <td>Ctrl+?</td> <td>ASCII码</td> <td>配置项</td> <td>作用</td> </tr> <tr class="even"> <td>Ctrl+C</td> <td>0x03</td> <td><p>CONFIG_TTY_SIGINT=y</p> <p>CONFIG_TTY_SIGINT_CHAR=0x03</p></td> <td>向当前进程发出SIGINT信号</td> </tr> <tr class="odd"> <td>Ctrl+D</td> <td>0x04</td> <td><p>CONFIG_TTY_SIGINT=y</p> <p>CONFIG_TTY_SIGINT_CHAR=0x04</p></td> <td>向当前进程发出SIGINT信号</td> </tr> <tr class="even"> <td>Ctrl+R</td> <td>0x12</td> <td><p>CONFIG_TTY_LAUNCH=y</p> <p>CONFIG_TTY_LAUNCH_CHAR=0x12</p></td> <td><p>创建线程,线程由下面2个配置项指定:</p> <p>CONFIG_TTY_LAUNCH_ENTRYNAME</p> <p>CONFIG_TTY_LAUNCH_ENTRYPOINT</p></td> </tr> <tr class="odd"> <td>Ctrl+Z</td> <td>0x1a</td> <td><p>CONFIG_TTY_SIGTSTP=y</p> <p>CONFIG_TTY_SIGTSTP_CHAR=0x1a</p></td> <td>向当前进程发出SIGTSTP信号</td> </tr> <tr class="even"> <td>Ctrl+“-”</td> <td>0x1F</td> <td><p>CONFIG_TTY_FORCE_PANIC=y</p> <p>CONFIG_TTY_FORCE_PANIC_CHAR=0x1F</p></td> <td>让系统崩溃(panic),这是为了打印当前系统栈信息等</td> </tr> </tbody> </table>
配置和使用:让系统崩溃
要想使用组合键让系统崩溃,可以如下配置:
CONFIG_TTY_FORCE_PANIC=y # 使能这个功能
CONFIG_TTY_FORCE_PANIC_CHAR=0x1F # 指定特殊字符
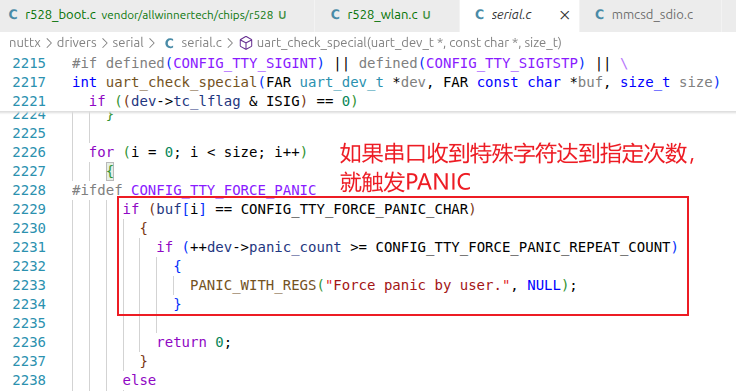
CONFIG_TTY_FORCE_PANIC_REPEAT_COUNT=3 # 收到几次才触发PANIC
内部机制
参考文件“docs/zh-cn/device_dev_guide/driver/bus_driver/UART/UART.md”:
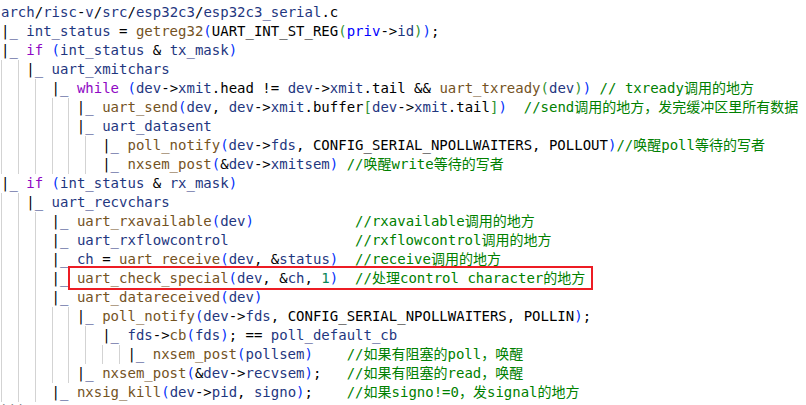
对于本课程使用的开发板,流程如下:
// vendor/allwinnertech/chips/r528/r528_serial.c
uart_interrupt
// nuttx/drivers/serial/serial_io.c
uart_recvchars
// nuttx/drivers/serial/serial.c
uart_check_special
串口接收中断函数里,最终会调用“uart_check_special”函数来检查有没有收到特殊字符,如果收到则如下处理:
其他命令
几个常用命令用法如下:
nsh> help mb
mb usage: mb <hex-address>[=<hex-value>] [<hex-byte-count>]
nsh> help mh
mh usage: mh <hex-address>[=<hex-value>] [<hex-byte-count>]
nsh> help mw
mw usage: mw <hex-address>[=<hex-value>] [<hex-byte-count>]
nsh> help hexdump
hexdump usage: hexdump <file or device> [skip=<bytes>] [count=<bytes>]
nsh> help pidof
pidof usage: pidof <name>
“mb/mh/mw”命令,分别用来以“字节/半字(2字节)/字(4字节)”为单位读取或写如某个地址。
示例如下:
nsh> mb 40000000 # 读0x40000000地址数据,读1个字节
0x40000000 = 0x67 # 值为0x67
nsh> mb 40000000=77 # 写0x40000000地址,写1个字节,数值为0x77
0x40000000 = 0x67 -> 0x77
nsh> mb 40000000 # 读出验证
0x40000000 = 0x77
nsh> mb 40000000 2 # 从0x40000000开始读2个字节
0x40000000 = 0x77
0x40000001 = 0x45
“hexdump”明白可以用来读取文件或驱动程序,“skip=N”表示跳过前面N字节,“count=M”表示读取M字节。比如:
nsh> hexdump /data/1.wav count=10
/data/1.wav at 00000000:
0000: 52 49 46 46 c6 29 00 00 57 41 RIFF.)..WA
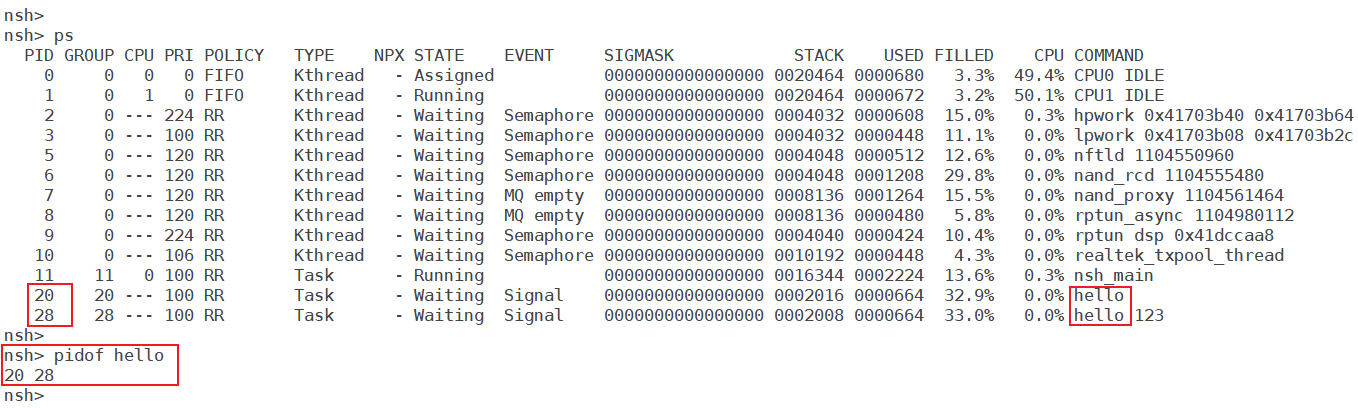
“pidof”用来列出指定名字的进程,比如: